Система платформы
Мониторинг прод-систем
Отдельная система наблюдения за прод-сервисами платформы. Коллектор опрашивает все цели раз в минуту, движок правил поднимает инцидент по порогу, дежурный получает сообщение в Telegram раньше, чем о сбое напишет пользователь.
В работеДежурный и Ops
Фоновых проб здоровья
8
Опрос целей
60сек
Разделов Ops
10
Уровня порогов
3
Обзор целей мониторинга
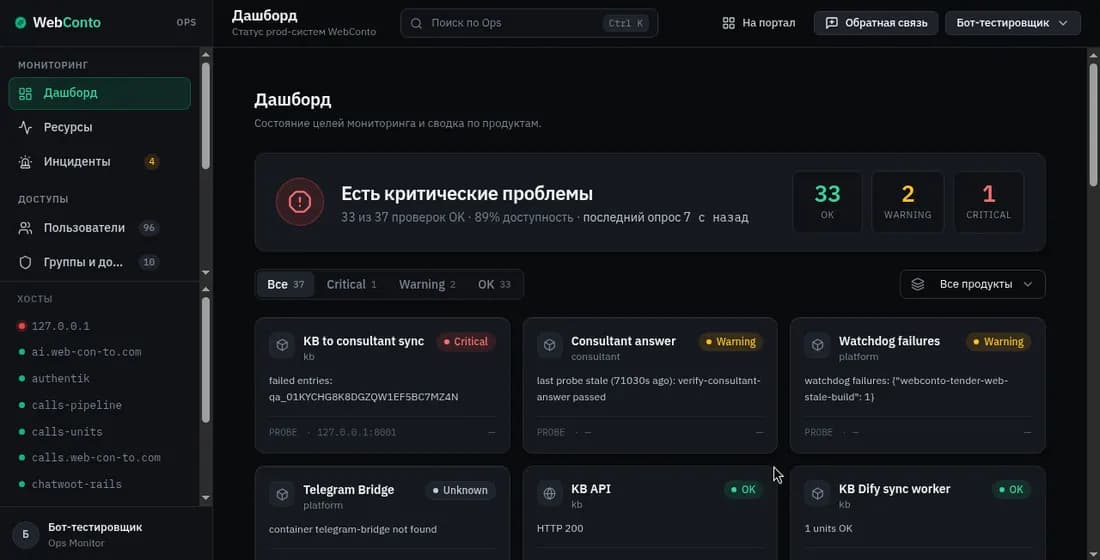
Цели под наблюдением
consultant-apiok
Healthz раз в минуту плюс синтетический запрос к модели каждые 10 минут. Ловит случай «UI работает, модель мертва», который обычный healthz пропускает.
Путь инцидента
01ОпросКоллектор опрашивает каждую цель раз в минуту и пишет результат в SQLite.
02ПравилаПороги warning / critical / predictive сравниваются с историей — не только с последним значением.
03ИнцидентОткрывается в UI, попадает в журнал событий; подтверждение дежурного снимает его с обзора.
04ОповещениеСообщение дежурному в Telegram с кулдауном на правило — сбой не заваливает чат повторами.
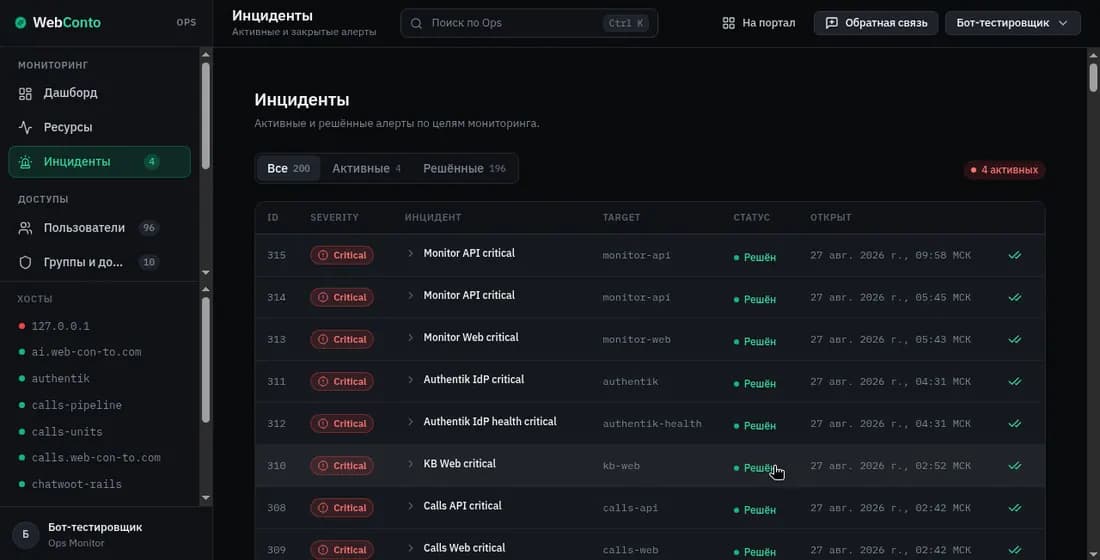
Инциденты
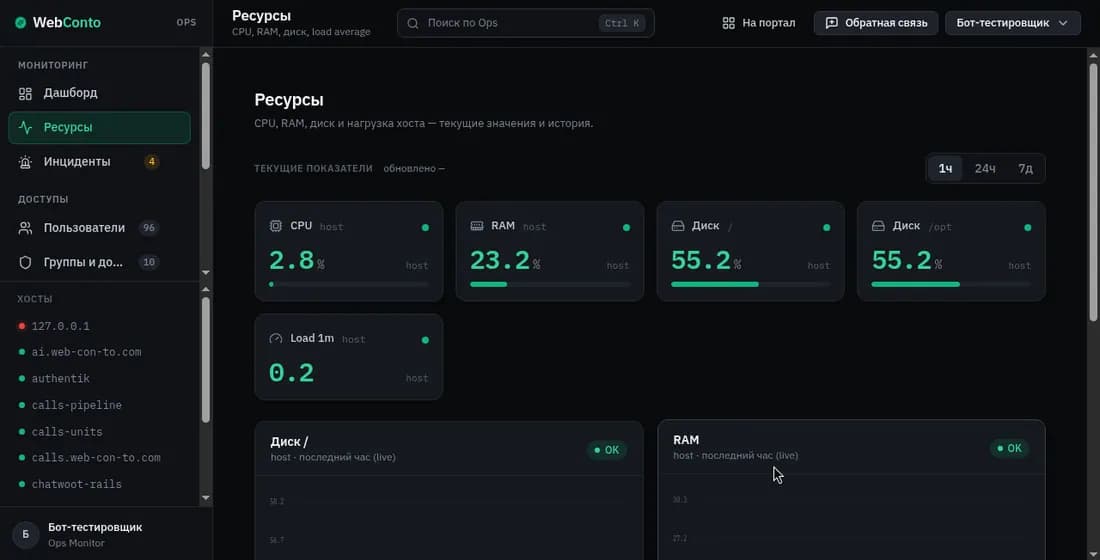
Ресурсы
Как устроено наблюдение
Пороги, журнал и граница с вотчдогом.
Общие правила: безопасность и развёртывание →УзелКак устроено
Только наблюдениеМониторинг не перезапускает сервисы — это задача вотчдога. Здесь только фиксация и оповещение.
Журнал событийКаждое открытие инцидента, подтверждение и административное действие пишется в общий аудит.
Метрики PrometheusДоступность целей, диск и память отдаются наружу для общего дашборда Grafana.
Пороги настраиваютсяРеестр целей и порогов — обычный файл конфигурации, изменения проходят через git.
IdP-админка на местеПользователи, группы, инвайты клиентов и SSO 1С управляются прямо здесь, без отдельного консоли.
Границы продукта
Мониторинг не чинит сбой сам — это делает вотчдог по своим правилам восстановления. Здесь только наблюдение, история и своевременное оповещение дежурного.
Показать инструмент вживуюПокажем цели, пороги и как дежурный получает оповещение.